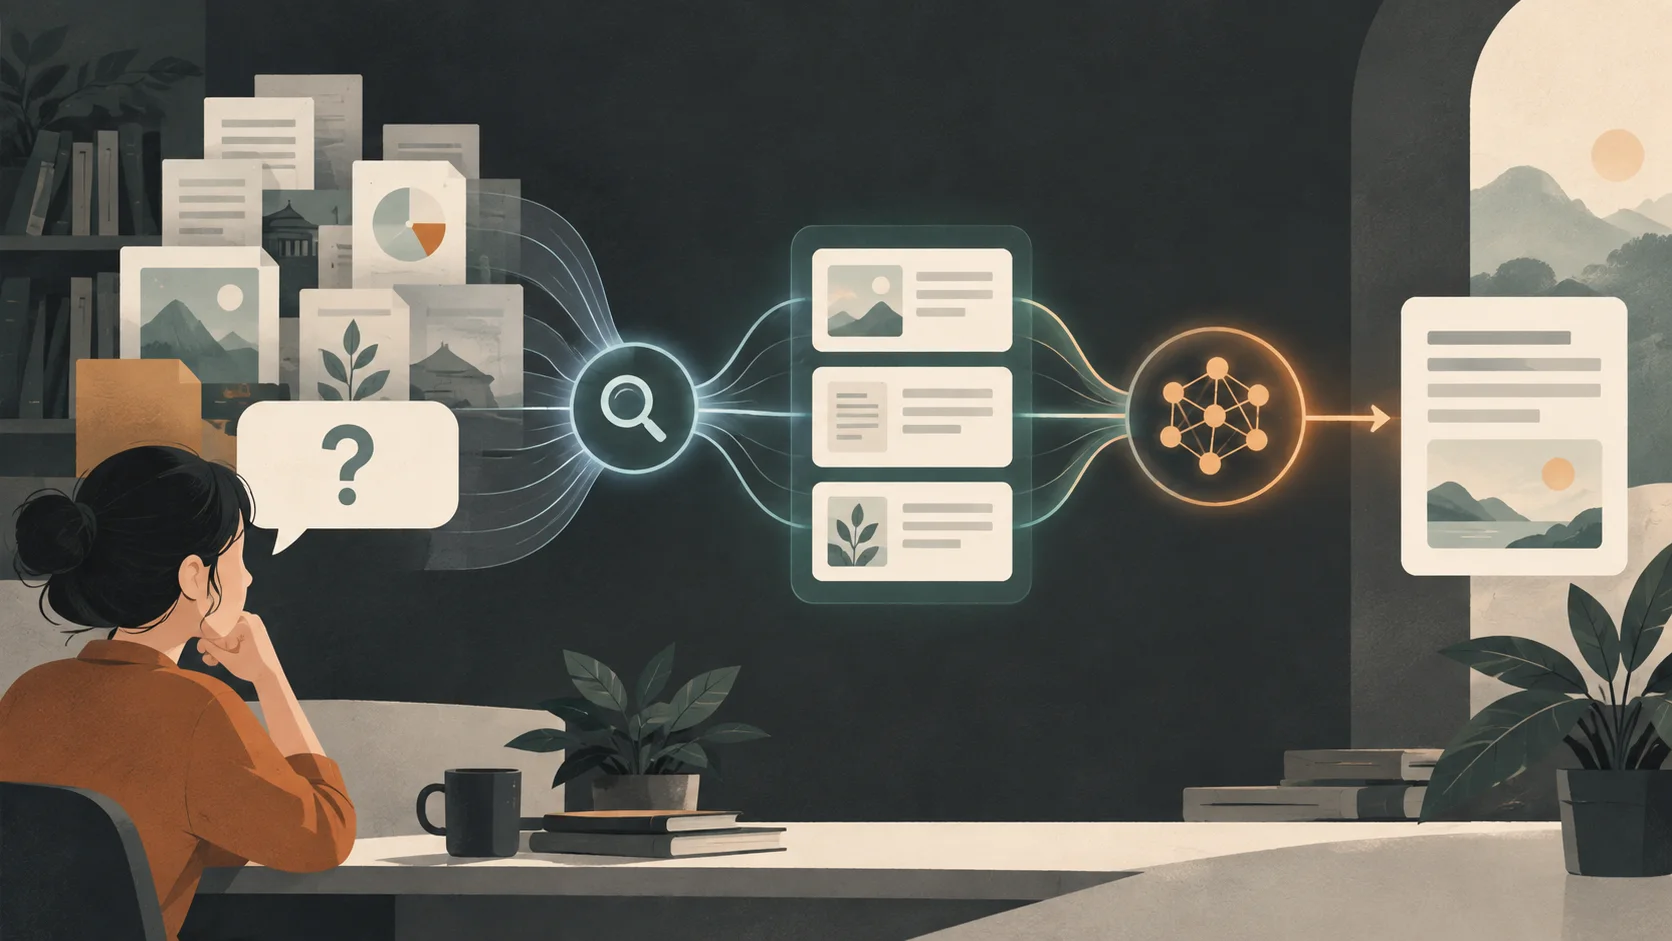
RAG 是什麼?一句話說,RAG(Retrieval-Augmented Generation,檢索增強生成)會在模型回答前,先從外部資料找出和問題相關的內容,再把這些內容連同問題送進生成流程。它不是重新訓練模型,也不是把整份文件不加整理地貼進 Prompt。
這個差異聽起來不大,實際上會改變你排查 AI 回答的方式。回答錯了,問題可能出在資料沒有進來、搜尋找錯段落、權限讓模型看不到資料、來源本身已經過期,或模型拿到正確內容後仍然自行補了一句。只盯著最後那段文字,通常很難知道是哪一層出了問題。
本文把 RAG 當成一個需要驗收的資料流程來談。你會看到它如何把文件整理成可檢索資料,查詢怎麼找到內容,哪些地方會讓引用看起來很完整但其實答非所問,以及何時用 Prompt、長脈絡或微調會比較直接。文中的概念查證到 2026-09-18;不綁定任何單一廠商,也不假裝有某個帳號、方案或產品介面可以直接讀回。
文章目錄
RAG 的核心答案:讓模型先找資料,再寫回答
RAG 最容易理解的版本是「先查,再寫」。使用者提出問題後,系統先到一個外部資料集合中取回相關內容,接著把問題和取回的內容交給語言模型,最後才產生回答。AWS 的說明把外部權威知識庫和 LLM 生成分成兩個角色;Google Cloud 則把 RAG 描述成資訊檢索系統與生成式 LLM 的組合。這兩份文件的產品脈絡不同,但都支持同一個基本理解:RAG 的重點在生成前的資料取得,而不是換一個更會聊天的模型。
原始 RAG 論文用兩種記憶來描述這件事。模型參數裡的知識可以想成 parametric memory,外部的文件索引則是 non-parametric memory。論文研究的是讓模型透過檢索存取外部記憶,不代表所有今天的 RAG 產品都採用完全相同的架構。這個區分對日常工作很有用,因為「模型本來學過什麼」和「這次系統到底找了哪份文件」是兩個不同的查核問題。
模型記憶和外部資料是兩件事
假設你要做一個公司內部規範問答。模型可能知道一般的請假制度,也能寫出很像規章的句子,但它不會因為語氣很肯定,就自動知道你公司今年 7 月才改過的申請流程。RAG 的做法是把目前允許使用的規範放進資料來源,在問題進來時找出相關段落,再讓模型依這些段落回答。
這裡有一個容易被過度承諾的地方。RAG 能讓系統有機會接觸較新的、私有的或專門領域資料,但它不會自動替資料做事實查核,也不會保證模型只使用取回的內容。AWS 明確把「沒有答案卻生成虛假資訊」、「資料過期」和「使用非授權來源」列為 LLM 的挑戰;RAG 是處理這些問題的一種方法,不是消除問題的保證書。
RAG 不等於把所有資料塞進 Prompt
把一份文件全文貼進 Prompt,和 RAG 有相似的地方,都是把外部資訊交給模型,但工作條件不同。前者比較像一次性的人工提供資料,後者還包含資料整理、索引、查詢、篩選、權限和監控。當資料少、任務只做一次,直接提供一小段內容可能已經夠用。當資料會更新、問題會重複出現,或使用者只能看到自己有權限的文件,才有理由把檢索層當成獨立系統設計。
我會先記住下面這個判斷:RAG 解決的是「回答前要找哪些外部內容」的問題。它不直接解決輸出格式、語氣、模型推理能力或流程權限。這些責任可能落在 Prompt、模型、工具層或應用程式本身,不能全部丟給 RAG。
一個 RAG 系統到底做了哪些事?
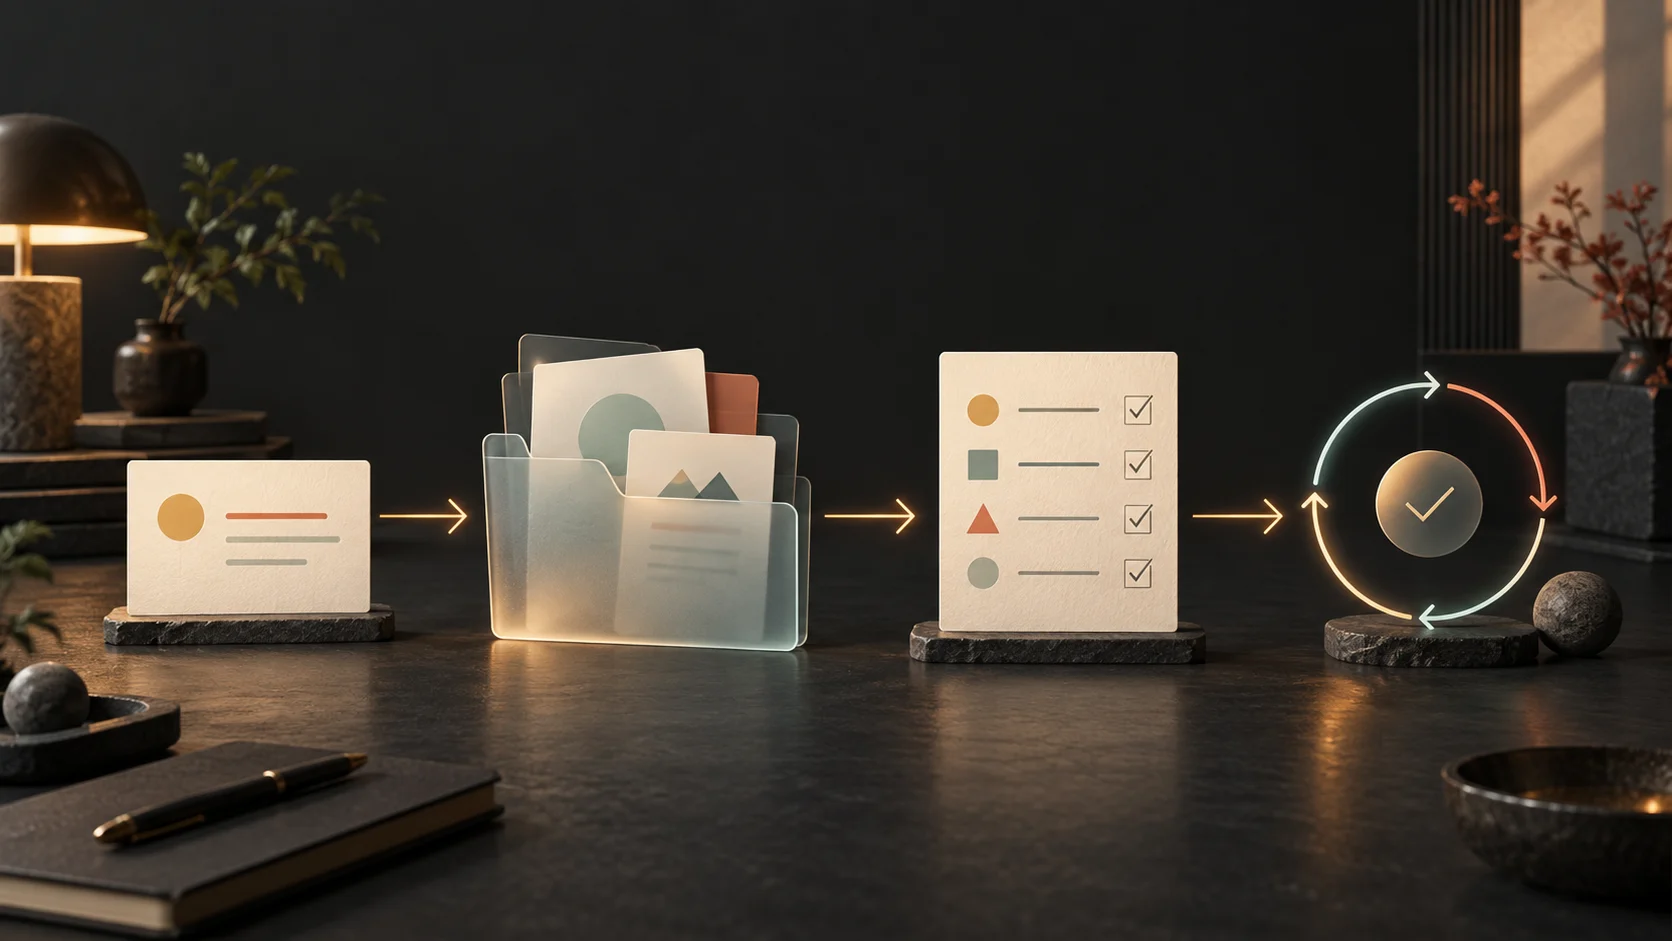
別把 RAG 想成一個單獨的向量資料庫。向量索引可能是其中一個元件,但完整流程通常還要處理來源文件、文字解析、切塊、嵌入、檢索、重排、脈絡組合、回答生成和結果驗收。AWS 將流程說成先由資訊擷取元件找資料,再把使用者查詢和相關內容交給 LLM;Microsoft 的 RAG 架構文件則把文件準備、索引、搜尋策略和端到端評估拆成不同階段。
第一步:整理要被回答的來源
先決定哪些文件可以回答問題,以及誰有權限讀它們。政策文件、產品手冊、研究報告、客服紀錄或資料表,可能有不同的更新頻率和可信程度。把所有檔案丟進同一個資料夾,並不會自動得到一個可以維護的知識庫。
本文建議在匯入前至少保留來源名稱、版本、日期、擁有者和存取範圍。這是治理與可追溯性的實務建議,不是某一家供應商的固定欄位規格。若文件沒有來源、日期或負責人,回答出錯時你很難知道該修資料、修檢索條件,還是修 Prompt。
第二步:解析文件並切成可搜尋的片段
檢索通常不是對整份 PDF 或整個網頁做一次模糊比對,而是先把文件分成較小的片段。片段太短,定義和限制可能被拆開;片段太長,搜尋結果可能帶進很多無關內容,讓後續脈絡變得肥大。表格、標題、附註和頁面順序也會影響解析結果。
切塊沒有一個可以套用到所有資料集的神奇數字。技術上你可以調整片段大小、重疊範圍、標題保留、metadata 和查詢改寫,但最後仍要用真實問題驗收。Microsoft 的資訊檢索文件把搜尋品質評估列為獨立階段,這個安排很合理,因為切塊設定不是寫進設定檔就算完成。
第三步:建立索引並執行查詢
系統可以用關鍵字搜尋、向量搜尋或混合搜尋找到候選片段。向量搜尋比較接近語意相似度,關鍵字搜尋則對專有名詞、編號和精確字串很有用。Microsoft 的 Azure AI Search 文件示範了把全文搜尋和向量搜尋合併,再用 Reciprocal Rank Fusion 重排結果。這是某個平台的實作方式,不代表每一個 RAG 系統都必須使用同一套搜尋引擎或排名演算法。
第四步:把取回內容組成生成脈絡
找到片段後,系統還要決定哪些內容放進模型的上下文、要不要保留來源標記、要不要依權限過濾、相似片段是否去重,以及資料不足時要不要停止回答。這個步驟常被一個「把搜尋結果貼進 Prompt」的簡化說法蓋掉,但它會直接影響答案能不能回到原始內容。
第五步:生成回答並留下可查的依據
模型根據問題和取回的內容寫出答案。應用程式可以同時保存查到的片段、來源 ID、查詢、模型設定與回答,讓日後能重現一次失敗。畫面上有沒有顯示引用連結,則依產品或自行開發的 UI 而定。本文沒有取得任何特定產品帳號,因此不把「用了 RAG」改寫成「一定會顯示可點擊引用」。
你可以先用這張表檢查流程有沒有斷在中間:
| 階段 | 你要確認的問題 | 失敗時常見現象 |
|---|---|---|
| 來源整理 | 文件版本、擁有者和權限是否清楚? | 回答引用了舊規範或不該看的資料 |
| 解析與切塊 | 標題、表格、限制條件是否保留? | 搜得到關鍵字,但缺少上下文 |
| 索引與檢索 | 查詢能否找到真正相關的片段? | 回答很流暢,依據卻不相干 |
| 脈絡組合 | 是否去重、排序、過濾與標示來源? | 重要段落被雜訊擠掉 |
| 生成 | 回答是否只做有根據的推論? | 取回資料正確,答案仍自行加戲 |
| 驗收 | 是否保留問題、結果和錯誤分類? | 下一次改設定只能靠感覺 |
資料怎麼進入檢索層:文件、切塊、嵌入與權限
RAG 的效果常被歸因於模型,其實資料準備往往更早決定結果。這不是說模型不重要,而是模型沒有拿到正確內容時,再好的生成能力也只能在錯的脈絡上工作。
文件先整理,不是丟進資料夾就完事
如果同一個規範有草稿、正式版、掃描版和一份寄在信箱裡的例外說明,系統即使都能搜尋到,也可能把不同版本混在一起。建議先建立來源清單,再決定哪些資料進入索引。這一步屬於本文建議,依據是 RAG 系統需要可控的外部來源,而不是任何供應商都規定同一個文件治理流程。
來源清單至少要能回答四件事:這份資料是什麼、最後更新何時、誰負責、哪些人可以使用。若問題涉及個人資料、合約或客戶內容,權限過濾應在檢索階段就處理,不要等模型回答完才想著把敏感字串刪掉。後者可能已經把不該看的內容送進模型,也可能把回答修到失去原意。
切塊大小沒有通用答案
切塊可以從文件結構開始,而不是先迷信某個 token 數。標題和它的段落通常應該保留在一起;步驟、前置條件、例外狀況也不適合被硬切成彼此獨立的句子。對有大量表格的文件,還要確認欄名沒有和儲存格內容分離。
這些做法是技術上合理的設計方向,不是我對所有資料集的實測結果。真正要調參數,請用一組固定問題測試,記下取回片段和答案,再比較修改前後。只看一兩個「看起來答對」的例子,很容易把偶然當成設定已經穩定。
嵌入、關鍵字和混合搜尋各自解決不同問題
語意嵌入可以把文字轉成可比較的表示,讓意思相近但字面不同的問題有機會找到相關段落。關鍵字搜尋對產品編號、錯誤代碼、API 名稱和人名這類精確字串通常更直觀。混合搜尋把兩者放在同一個查詢流程裡,再依規則合併或重排結果,是一種常見的工程方向。
「用向量資料庫」不等於「已經做好 RAG」。如果使用者問的是一個不在來源裡的問題,系統仍需要能說明找不到;如果來源資料互相矛盾,系統也需要有版本或權威性規則。檢索只是把候選資料找出來,最後能不能回答仍要回到來源內容和驗收題目。
查到資料,不代表回答就正確:RAG 的四個失敗點
RAG 最值得建立的觀念,是把錯誤拆成不同層。Microsoft 的 RAG evaluators 文件把 retrieval、groundedness、relevance 和 completeness 分開處理。這四個詞不是裝飾性的英文名詞,而是幫你決定下一步要查哪一段:是找錯資料、沒有依據、答非所問,還是漏掉重要資訊。
失敗一:檢索沒有找到需要的資料
問題可能使用了和文件不同的詞,也可能因為切塊太碎、metadata 缺失、查詢改寫不佳或索引未更新,讓正確段落根本沒有進候選結果。這時直接修改生成 Prompt 往往沒用,因為模型手上沒有那段內容。
先保存 query、top-k 結果和來源 ID,再檢查「真正相關的段落是否出現」。若沒有,優先查來源整理、切塊、搜尋方式與重排,不要先說模型胡說。
失敗二:檢索找到了,但上下文不完整
片段可能包含答案的一半,卻缺少前置條件、日期、例外或表格欄名。模型看到一些正確字句後,會很容易補出一個聽起來完整的答案。這不是引用存在就代表回答被充分支持。
這裡要檢查的不只是「有沒有命中」,還有命中的片段是否足夠回答這個問題。Microsoft 對 response completeness 的說明就是在處理這個面向:回答可能沒有捏造,但仍漏掉 ground truth 裡的重要資訊。
失敗三:來源正確,但資料或權限已經過期
RAG 能接入外部資料,不代表資料自動新鮮。索引更新失敗、快取未清、文件版本沒有標記,都可能讓系統拿到舊內容。若不同使用者的權限不同,還要驗收同一個問題在不同身份下是否取回不同來源。
這部分通常不是 Prompt 小修就能解決。你需要資料更新紀錄、索引狀態、權限測試和失敗後的處理方式。涉及客戶或內部資料時,這個檢查比回答多寫兩句摘要重要得多。
失敗四:模型拿到正確資料,仍然超出資料回答
生成模型的任務是產生文字,不是自動變成資料庫查詢器。它可能把來源內容整理得不錯,也可能在段落之間補上一個來源沒有說的結論。因此要另外檢查 groundedness,也就是回答是否有根據取回的脈絡,而不是只檢查 retrieval 是否成功。
我會把結果分成下面四類,讓排查有一個起點:
| 檢查面向 | 問題 | 下一步 |
|---|---|---|
| Retrieval | 找到的片段和問題相關嗎? | 查 query、切塊、索引、搜尋與重排 |
| Groundedness | 回答中的主張有被取回內容支持嗎? | 把每個主張對回來源,檢查模型是否補寫 |
| Relevance | 回答有直接處理使用者問題嗎? | 查問題改寫、Prompt 和輸出格式 |
| Completeness | 重要條件、例外和步驟有漏掉嗎? | 建立期望答案或檢查清單再重跑 |
RAG 與 Prompt、長脈絡、微調、Web Search 有何不同?
這幾個詞常被一起拿來比較,但它們處理的層次不一樣。下面是工作方法上的對照,不是任何供應商宣稱的產品排名。
| 方法 | 主要處理的問題 | 適合先用的情境 | 要注意的邊界 |
|---|---|---|---|
| Prompt | 告訴模型任務、格式、限制和判斷規則 | 任務固定、資料已經在當次脈絡中 | 不會自動管理會更新的外部知識 |
| 長脈絡 | 一次提供較多文件或對話內容 | 文件數少、需要跨段落閱讀 | 成本、雜訊、上下文容量和資料權限仍要處理 |
| RAG | 依問題從外部資料取回相關脈絡 | 私有、專門或會更新的資料,且問題會重複出現 | 檢索錯了,生成可能在錯的脈絡上變得更有說服力 |
| 微調 | 改變模型在特定資料或格式上的行為 | 需要穩定風格、格式或任務模式 | 不應把快速變動的事實全部當成模型參數 |
| Web Search | 取得公開網路上的即時或外部資訊 | 問題需要公開資料且能接受搜尋來源 | 不等於私有知識庫,也不代表每個結果都可信 |
OpenAI 的 Prompt Engineering 文件和 Anthropic 的 Prompt Engineering Overview 都把成功標準與測試放在提示修改之前。這個原則和 RAG 一樣:先定義答案什麼叫可接受,再決定要改 Prompt、改資料、改檢索,還是換一種架構。你可以先讀站內的 ChatGPT Prompt 教學和 Context Engineering 介紹,再回來看 RAG 在整個脈絡設計裡的位置。
如果你有一份很短、很穩定的文件,直接提供給模型可能比建完整檢索管線省事。如果你要處理數千份會更新的規範,才值得把資料治理和 retrieval evaluation 一起算進來。規模不是唯一條件,更新頻率、權限和回答出錯的代價通常更能改變選擇。
哪些任務適合 RAG,哪些不要急著做?
適合先評估 RAG 的情境
以下條件出現兩三項時,RAG 通常值得進入候選名單:
- 問題需要私有或專門領域資料,而通用模型不會自動知道。
- 文件會更新,回答需要回到某個日期或版本。
- 同一批資料會被重複詢問,不想每次手動整理全文。
- 讀者需要查看來源、版本或引用依據。
- 不同使用者只能看到不同資料,權限要跟著檢索走。
這些是架構選擇條件,不是「用了就一定準」的承諾。Google Cloud 把 RAG 和 grounding 放在需要新鮮、私有或專門資料的 LLM 應用與 agent 情境;你仍然要用自己的問題集驗收是否真的找到有用內容。
不要急著用 RAG 的情境
如果任務只是把一段已知文字改寫成固定格式,RAG 可能只是多了一個需要維護的中間層。如果資料只有幾份,而且每次都由同一個人明確挑選,直接提供文件比較容易追蹤。如果問題本身需要精確計算,應優先考慮資料庫查詢或程式計算,再讓模型負責解釋結果。
還有一種情況更應該暫停:你不知道哪些來源可以用,也沒有能力驗收不同身份的權限。這時先做資料治理和小型測試集,比先買向量資料庫或堆更多模型更實際。工具可以晚一點再開,資料責任不會因為介面很漂亮就消失。
用一個小題目做 RAG proof-of-concept:六步驗收
不用一開始就把整個公司資料庫搬進去。先選一個範圍小、答案能檢查、失敗代價可控的題目,做一個能留下中間結果的 proof-of-concept。Microsoft 的 RAG 評估文件建議把測試文件、查詢、切塊、嵌入、索引、搜尋策略和端到端結果分階段檢查;這比只拿幾句展示回答來判斷可靠得多。
1. 先定義問題,不先選模型
寫出 10 到 20 個真的會被問到的問題,並加入至少幾個答案不在資料裡的問題。問題要包含精確名詞、同義說法、跨段落條件和需要版本判斷的例子。若只測「文件標題加上原文句子」,檢索結果會漂亮得不自然。
2. 固定來源與權限
為每個問題標出理想來源、可接受的版本和不應被取回的資料。這份清單不用很大,但要能讓你在看到錯誤結果時說明它是漏找、找錯還是權限不該通過。
3. 保存檢索結果,不只保存最後回答
每一次測試至少記下 query、取回片段、來源 ID、排名或分數、模型輸入和回答。沒有這些中間資料,你只能說「這次答錯了」,不能說明是哪個元件需要修。
4. 先評估 retrieval,再評估回答
Microsoft 的檢索評估文件列出 Precision@K、Recall@K 和 Mean Reciprocal Rank(MRR)等方法。你不一定需要立刻導入完整的數學儀表板,但至少要先標記:正確來源有沒有出現在前幾個結果,第一個相關結果排在哪裡,無法回答的問題是否錯誤取回了看似相關的文件。
5. 把 groundedness 和 completeness 分開
回答沒有引用來源以外的內容,不代表它已經完整回答。反過來,回答寫得很完整,也不代表每個主張都有依據。Microsoft 的 evaluator 文件把 groundedness 看成是否超出 grounding context,也把 response completeness 看成是否漏掉 ground truth 的重要資訊。這兩項應該分別記錄,不能用一個總分遮掉差異。
6. 用版本化測試確認修改沒有倒退
切塊、搜尋、Prompt 或模型任何一項改了,都重跑固定題目,保留修改前後結果。先記錄哪些題目變好、哪些變差、哪些仍然 unknown,再決定要不要繼續調。若資料會每天更新,還要加一個「目前版本應該被找出來」的題目,避免索引停在舊資料卻沒人發現。
你可以用下面的最小驗收表開始,不必一開始就追求漂亮的 dashboard:
| 測試欄位 | 最低要求 | 結果記法 |
|---|---|---|
| 問題 | 有答案、同義問法、無答案題 | 通過/失敗/unknown |
| 來源 | 理想文件、版本、權限 | 命中/漏找/不應命中 |
| Retrieval | 相關片段出現在設定的前幾名 | 記錄排名與片段 |
| Groundedness | 回答主張能對回取回內容 | 通過/有超出內容 |
| Completeness | 重要條件和例外沒有漏掉 | 完整/缺漏/需人工判斷 |
| 回歸 | 修改後固定題目重跑 | 改善/倒退/無法比較 |
這張表是本文建議的起步版本,不是保證 RAG 上線安全的正式標準。醫療、法律、金融、個資或會直接改變權益的情境,還需要依領域規範增加人工審核、存取控管與稽核證據。
RAG 不是模型外掛,而是一個需要維護的資料流程
開始做 RAG 後,最容易被低估的是維護。文件會更新,索引可能失敗,權限會改,來源可能被刪除,模型版本也可能變動。這些狀態如果沒有被記錄,系統一開始答得不錯,過幾週仍可能悄悄變成引用舊規範的聊天機器人。
我會把維護拆成四個責任:來源負責人要確認內容和版本,資料流程要確認解析與索引完成,檢索層要保存 query 和結果,應用層要讓人能查看依據並在不確定時停止。這是我的分法,你可以依團隊人數合併,但每一項都要有人簽名。
如果你的 AI 還要連接外部工具、資料庫或 API,可以再讀站內的 MCP 是什麼?,理解連接協定和 RAG 檢索層不是同一件事。如果你正在設計一個會讀檔、呼叫工具並執行任務的 agent,AI Agent Harness 介紹會處理模型之外的執行責任;RAG 只負責其中一段資料取得與脈絡提供。想看產品化研究工具的例子,可以延伸到 NotebookLM 教學,但不要把某一個產品的介面行為直接當成 RAG 的唯一標準。
RAG FAQ:常見問題
RAG 是一個模型嗎?
不是。RAG 通常指一種把資訊檢索和生成模型組合起來的架構或工作流程。原始研究把參數化模型記憶和可檢索的外部記憶放在一起討論,但今天的實作可以使用不同模型、搜尋方法、資料庫和權限層。看到「RAG 模型」這個說法時,要再確認對方是在講研究模型、產品功能,還是整套應用流程。
RAG 會消除 AI 幻覺嗎?
不會有這個保證。RAG 可以提供外部脈絡,讓回答有機會根據較新或較專門的資料,但它仍可能找錯、漏掉限制,或在正確片段之外自行補寫。驗收時要分開看 retrieval、groundedness 和 completeness,不要因為答案附了一個來源連結,就直接當成內容已查證。
RAG 一定要用向量資料庫嗎?
不一定。向量搜尋是常見作法之一,關鍵字搜尋、混合搜尋、資料庫查詢或其他檢索方式也可能成為整體流程的一部分。RAG 的核心是生成前取得外部資料並用它提供脈絡,不是某一種資料庫品牌或單一索引格式。真正的選擇要看資料型態、查詢方式、權限、更新速度和驗收題目。
RAG 和微調要怎麼選?
如果你要讓模型遵守固定格式、口吻或任務模式,可以評估 Prompt、微調或其他行為控制方法。如果你要接入會更新的私有文件,RAG 通常更直接,因為資料可以在檢索層更新,不必每次把新事實重新變成模型參數。這只是一般架構判斷,實際選擇仍要看資料規模、成本、權限和測試結果。
ChatGPT 或其他聊天工具上傳文件,就是 RAG 嗎?
不能只從「可以上傳文件」這個介面現象,斷定產品內部一定採用哪一種 RAG 實作。產品可能使用檔案搜尋、上下文載入、摘要、快取或其他組合,功能名稱也會隨版本和方案變動。若你需要知道實際檢索方式、資料保留、引用顯示或權限行為,應查該產品當日的官方文件和自己的帳號讀回;本文沒有做這些產品內部驗證。
RAG 的回答一定會附上可點擊的引用嗎?
不一定。系統可以保存來源 ID、文件名稱和片段,也可以把它們渲染成畫面上的引用,但是否顯示、顯示到什麼程度,以及使用者能不能點回原文,依產品或自建介面而定。即使畫面有引用,也應檢查引用是否真的支持回答中的主張。
沒有很多文件,也需要做 RAG 嗎?
通常不必急著做完整管線。若資料少、內容穩定、每次任務都由人明確挑選文件,直接提供相關內容可能比較容易驗收。只有當資料會更新、問題會重複、需要依權限檢索,或需要持續保存來源依據時,RAG 的維護成本才比較有機會換來實際價值。
RAG 值不值得做,看四件事就夠:資料找不找得到、權限對不對、答案能不能回到來源、改了設定之後能不能重跑同一組題目。模型回答像不像人,反而是最後才看的。先拿一個範圍小的問題集做驗收,通常比先把所有文件匯入更快知道方向。若你還在整理 Prompt 和模型脈絡,可以從 Context Engineering開始;若要接特定產品,再去讀那個產品當天的官方文件。
查證邊界
本文概念查證到 2026-09-18。RAG 的定義依 2020 年的原始論文,架構與評估方法依 AWS、Google Cloud 與 Microsoft Learn 當日的文件。我沒有拿任何一個 RAG 產品的帳號來測,所以文中不描述特定產品的引用畫面、資料保留規則、方案或價格;準確率、速度、成本改善幅度也沒有實測數字。這些都要用你自己的資料和問題集驗收。
參考來源
- AWS:什麼是 RAG?檢索增強生成 AI 說明,查閱日期:2026-09-18。
- Google Cloud:What is Retrieval-Augmented Generation (RAG)?,查閱日期:2026-09-18。
- Microsoft Learn:Retrieval-Augmented Generation evaluators,查閱日期:2026-09-18。
- Microsoft Learn:RAG information retrieval phase,查閱日期:2026-09-18。
- Microsoft Learn:RAG LLM end-to-end evaluation phase,查閱日期:2026-09-18。
- Lewis et al.:Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,查閱日期:2026-09-18。
- OpenAI:Prompt engineering guide,查閱日期:2026-09-18。
- Anthropic:Prompt engineering overview,查閱日期:2026-09-18。